A IA lembra de você? Entenda memória, histórico e contexto
Você conta para uma IA que prefere explicações curtas, trabalha com educação ou não come determinado alimento.
Fecha a conversa.
Dias depois, abre um novo chat e aquela informação aparece novamente na resposta.
A reação mais natural é pensar:
“Ela lembrou de mim.”
Para o uso cotidiano, essa frase até funciona. Tecnicamente, porém, ela esconde mecanismos bem diferentes.
Uma informação pode estar no histórico de conversas, ter sido salva como memória, fazer parte de uma configuração de personalização ou ter sido recuperada pelo sistema apenas porque parece relevante para a pergunta atual.
E nada disso significa necessariamente que o modelo tenha sido treinado novamente ou que aquela informação tenha sido gravada permanentemente “dentro da IA”.
A distinção mais útil é esta:
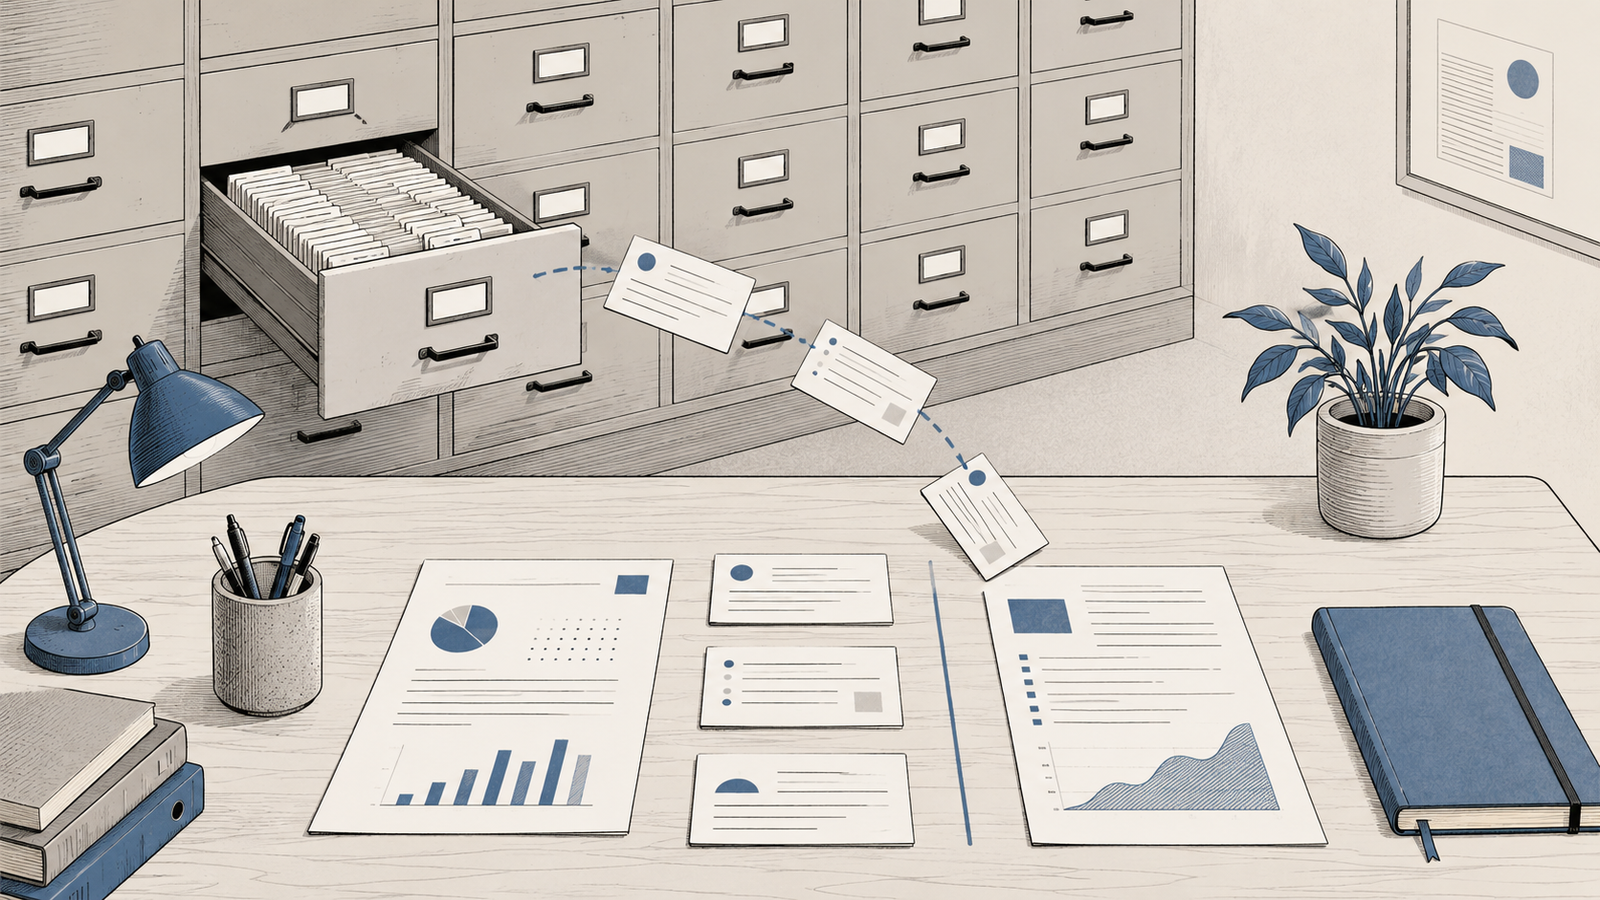
Contexto é o que está sobre a mesa agora. Histórico é o arquivo. Memória é uma forma de trazer informações desse arquivo de volta para a mesa. Treinamento é modificar a própria máquina que trabalha sobre ela.
Memória, histórico e contexto não são a mesma coisa
Grande parte da confusão começa porque, na interface, tudo parece continuidade da mesma conversa.
Por trás dela, porém, existem camadas diferentes.
Contexto
Contexto é o conjunto de informações disponibilizado ao modelo enquanto ele produz uma resposta.
Pode incluir sua pergunta atual, mensagens anteriores, instruções do sistema, documentos, resultados de ferramentas e, em alguns produtos, informações recuperadas de memórias ou conversas anteriores.
No artigo sobre janela de contexto, vimos que existe um limite para quanto material pode ser considerado e que simplesmente colocar mais informação nesse espaço não significa que tudo será utilizado igualmente bem.
Pense no contexto como a mesa de trabalho.
O modelo trabalha com aquilo que recebeu sobre essa mesa naquele momento.
Histórico
Histórico é o registro das conversas que o serviço mantém associado à sua conta.
Uma conversa aparecer na barra lateral, porém, não significa que todo o seu conteúdo esteja sendo enviado ou consultado em cada resposta futura.
Ela pode simplesmente estar armazenada.
Pense no histórico como um arquivo cheio de pastas.
O fato de uma pasta existir no arquivo não significa que ela esteja aberta sobre a mesa.
Memória
Memória é o nome usado por diferentes produtos para mecanismos que permitem reutilizar informações entre interações.
Pode ser uma preferência que você pediu explicitamente para guardar, um dado extraído de conversas anteriores ou uma representação resumida daquilo que o sistema considera relevante sobre você.
A implementação varia entre os serviços e nem todos os fornecedores revelam como essa informação é armazenada internamente.
O ponto importante é que memória persistente não precisa estar gravada nos parâmetros do modelo.
Ela pode existir em sistemas externos e ser recuperada quando necessária.
Treinamento
Treinamento é outra coisa.
Durante o treinamento, os parâmetros do modelo são ajustados a partir de grandes conjuntos de dados.
Isso é muito diferente de guardar uma preferência individual como:
“Prefiro respostas em português.”
Um sistema pode usar essa informação para personalizar suas próximas conversas sem retreinar o modelo inteiro por causa dela.
Então onde fica aquilo que a IA lembra?
Não existe uma resposta única.
Os fornecedores normalmente documentam o comportamento de seus recursos de memória, mas não necessariamente revelam toda a arquitetura usada no backend.
Sistemas desse tipo podem combinar bancos de dados tradicionais, resumos, índices de busca, representações vetoriais e mecanismos de recuperação.
Uma técnica importante nessa área é conhecida como RAG, ou geração aumentada por recuperação.
Em vez de depender apenas do conhecimento aprendido durante o treinamento, o sistema procura informações externas relevantes e as disponibiliza ao modelo no momento da resposta.
O trabalho que popularizou o RAG descreve justamente a combinação entre o conhecimento incorporado nos parâmetros do modelo e uma memória externa recuperável.
Isso também pode ser usado para informações pessoais.
Imagine que, meses atrás, você tenha informado:
“Quando recomendar restaurantes, considere que não como carne.”
Essa informação pode permanecer armazenada fora do modelo.
Quando você perguntar:
“Onde posso jantar hoje?”
o sistema pode identificar que sua preferência alimentar é relevante e disponibilizá-la para a geração daquela resposta.
É nesse sentido que a frase “a IA lembrou” funciona.
Mas é mais preciso dizer que o sistema recuperou uma informação anterior e a tornou disponível para a resposta atual.
A memória precisa entrar no contexto?
Conceitualmente, uma informação persistente precisa ser disponibilizada ao processo de geração de alguma forma para conseguir influenciar a resposta.
Isso não significa que todos os produtos simplesmente copiem uma frase de um banco de dados e coloquem no início de um prompt. As implementações reais podem ser muito mais sofisticadas e são, em grande parte, proprietárias.
Mas existe um princípio importante:
uma informação guardada e nunca recuperada não consegue influenciar aquela resposta.
Por isso memória não significa “lembrar de tudo”.
O sistema também precisa decidir o que vale a pena recuperar.
A IA sabe tudo o que eu já disse?
Não.
Essa é uma das interpretações mais perigosas da palavra memória.
Produtos podem guardar histórico e extrair informações dele, mas isso não significa que todas as mensagens que você já escreveu estejam disponíveis simultaneamente ao modelo.
Há limites de contexto, mecanismos de seleção, configurações de privacidade, diferentes tipos de memória e até separação por projetos.
Em alguns casos, uma informação antiga simplesmente não será recuperada.
Em outros, o sistema pode selecionar exatamente aquela informação porque ela parece útil para o pedido atual.
Por isso duas experiências aparentemente contraditórias são possíveis:
- a IA lembrar de um detalhe mencionado meses atrás;
- e esquecer algo dito há poucos minutos numa conversa complicada.
Os mecanismos envolvidos não são necessariamente os mesmos.
Como ChatGPT, Claude e Gemini fazem isso?
Os recursos mudam rapidamente e podem variar por plano, conta, região e configuração. O retrato abaixo corresponde à documentação consultada em 16 de agosto de 2026.
ChatGPT
A OpenAI documenta recursos que permitem ao ChatGPT usar informações persistentes entre conversas.
Uma distinção importante é que memórias salvas e histórico de conversas podem funcionar como camadas separadas.
Isso traz uma consequência pouco intuitiva: apagar uma conversa não significa necessariamente apagar uma memória que já tenha sido criada a partir dela.
A documentação da OpenAI orienta o usuário a gerenciar as memórias e suas fontes quando deseja remover completamente determinada informação.
O ChatGPT também possui conversas temporárias, destinadas a interações que não devem criar memória nem permanecer no histórico comum.
Claude
A Anthropic documenta tanto memória baseada em conversas quanto pesquisa em chats anteriores.
Um detalhe interessante é que a empresa afirma usar RAG para pesquisar conversas anteriores quando esse recurso é acionado.
Isso mostra claramente a diferença entre guardar uma conversa e recuperar uma parte relevante dela depois.
O Claude também oferece controles de memória e experiências que mantêm contextos separados por projeto, dependendo do plano e dos recursos disponíveis.
Gemini
O Google também oferece personalização baseada na memória de chats anteriores em contas elegíveis.
Seu funcionamento está relacionado às configurações de atividade e memória da conta, e o Google permite que o usuário gerencie essas opções.
A documentação também deixa claro que apagar ou desativar determinadas fontes de personalização pode exigir ações diferentes dependendo de onde a informação está armazenada.
Os detalhes variam entre esses produtos, mas o padrão é semelhante:
o modelo não precisa carregar dentro de seus parâmetros tudo aquilo que sabe sobre você. O produto pode manter informações externamente e disponibilizá-las quando forem relevantes.
Se a IA lembrou de mim, então ela aprendeu comigo?
Não necessariamente.
Essa é provavelmente a distinção mais importante deste artigo.
Personalização e treinamento são processos diferentes.
Uma preferência armazenada para ser usada nas suas próximas conversas pode existir apenas como dado associado à sua conta.
Treinar um modelo significa alterar seus parâmetros a partir de dados.
Os próprios serviços oferecem, em diferentes configurações, controles separados para personalização, histórico e uso de conteúdo na melhoria dos modelos.
Portanto, estas duas frases não são equivalentes:
“O sistema lembra que eu trabalho com educação.”
e
“Minha conversa foi incorporada ao treinamento do modelo.”
A primeira pode acontecer sem que a segunda aconteça.
Apagar o chat apaga a memória?
Depende do produto e do tipo de memória.
No ChatGPT, por exemplo, a OpenAI documenta que memórias salvas podem ser mantidas separadamente do histórico. Excluir apenas a conversa que originou aquela informação pode, portanto, não ser suficiente para remover a memória.
Em outros sistemas, a personalização pode depender diretamente das conversas armazenadas.
Por isso, se o objetivo for realmente remover uma informação, não assuma que apagar a conversa resolveu tudo.
Confira os controles de:
- memória;
- histórico ou atividade;
- personalização;
- arquivos enviados;
- aplicativos conectados.
Os nomes mudam de produto para produto.
Memória pode estar errada
Existe outro problema menos óbvio.
Memória não é necessariamente verdade.
Imagine que você diga:
“Acho que vou me mudar para Curitiba no ano que vem.”
Se o sistema transformar essa hipótese em:
“O usuário mora em Curitiba.”
uma interpretação incorreta pode passar a influenciar respostas futuras.
Também existem informações que eram verdadeiras e deixaram de ser.
Você pode mudar de emprego, abandonar um projeto, passar a preferir outro tipo de resposta ou deixar de seguir determinada dieta.
Uma memória útil hoje pode virar ruído amanhã.
E há ainda uma conexão com outro problema que já discutimos no Modo Real: a IA pode gerar informações falsas ou sem sustentação.
Se uma informação errada for tratada como memória confiável, o problema deixa de afetar apenas uma resposta e pode reaparecer no futuro.
Por isso, memória deveria ser tratada como contexto pessoal que também pode precisar de correção, não como fonte infalível.
Personalização demais também pode atrapalhar
A função da memória é evitar que você precise repetir certas coisas.
Mas existe um efeito colateral possível: o sistema pode começar a enxergar novos pedidos demais através de informações antigas.
Imagine que durante meses você peça explicações para iniciantes.
Depois aprende bastante e começa a querer respostas avançadas.
Se a memória continuar dizendo apenas:
“Prefere explicações básicas.”
a personalização passou de útil para limitante.
O mesmo pode acontecer com profissão, orçamento, preferências, objetivos e projetos.
Uma boa memória precisa conseguir esquecer, atualizar ou perder prioridade.
Uma nova conversa é realmente uma folha em branco?
Nem sempre.
Começar um novo chat normalmente remove a maior parte do contexto específico da conversa anterior.
Mas, se recursos de memória e personalização estiverem ativos, informações persistentes podem voltar a aparecer.
Isso significa que:
nova conversa não é necessariamente o mesmo que identidade zerada.
Essa diferença é importante quando você quer trabalhar com assuntos independentes.
Por exemplo, pode ser ruim transportar automaticamente:
- regras de um projeto para outro;
- preferências temporárias;
- hipóteses ainda não confirmadas;
- informações pessoais que não têm relação com a tarefa;
- contextos profissionais de clientes diferentes.
Nessas situações, vale usar projetos separados, desativar recursos de memória quando apropriado ou recorrer a conversas temporárias/incógnitas quando o produto oferecer essa opção.
Quando a memória é realmente útil?
Memória funciona melhor para informações relativamente estáveis e que evitam repetição.
Por exemplo:
- idioma preferido;
- forma de tratamento;
- estilo de resposta;
- restrições alimentares relevantes;
- objetivos de longo prazo;
- regras permanentes de um projeto;
- contexto profissional que realmente atravessa várias conversas.
Já informações transitórias merecem mais cautela.
“Hoje estou sem carro”, “estou preparando um evento na sexta” ou “quero uma resposta curta desta vez” provavelmente não deveriam virar características permanentes sobre você.
Uma regra prática é:
quanto maior a chance de aquela informação mudar, menor deveria ser a confiança numa memória antiga.
O que não vale a pena deixar na memória
Existe também uma questão de privacidade.
Se uma informação não precisa atravessar conversas, talvez não haja motivo para transformá-la em memória persistente.
Evite tratar recursos de memória como cofre para:
- senhas;
- tokens e chaves de API;
- dados bancários;
- documentos confidenciais;
- segredos empresariais desnecessários para a tarefa;
- informações sensíveis que não precisam ser reutilizadas.
A pergunta útil não é apenas:
“A IA consegue lembrar disso?”
mas:
“Existe algum motivo para ela precisar lembrar disso depois?”
Como usar memória sem perder o controle
Alguns hábitos simples ajudam.
- Revise periodicamente o que está salvo. Preferências e fatos pessoais mudam.
- Corrija informações antigas assim que perceber o problema. Não continue compensando uma memória errada em cada conversa.
- Separe projetos independentes. Contexto útil em um trabalho pode ser ruído ou até risco em outro.
- Use conversas temporárias quando não quiser continuidade. Os principais serviços oferecem diferentes mecanismos para interações menos persistentes.
- Não confunda memória com fonte. Se a IA lembrar que você disse determinada coisa, isso prova apenas que aquela informação foi associada a você — não que seja verdadeira hoje.
- Confira as configurações do produto. Memória, histórico, personalização e treinamento podem ter controles separados.
Perguntas frequentes
Fechar uma conversa faz a IA esquecer tudo?
Não necessariamente. O conteúdo específico daquela conversa pode deixar de fazer parte do contexto imediato, mas histórico e recursos de memória podem manter informações entre sessões.
A IA guarda todas as minhas conversas na memória?
Não é correto tratar histórico e memória como sinônimos. Uma conversa pode estar armazenada sem que todo o seu conteúdo seja utilizado futuramente.
Se a IA sabe meu nome, ele foi gravado dentro do modelo?
Não necessariamente. Essa informação pode estar armazenada externamente e ser fornecida ao modelo quando relevante.
Desativar o treinamento também desativa a memória?
Não necessariamente. São controles conceitualmente diferentes e, em alguns produtos, podem ser configurados separadamente.
Apagar uma conversa apaga tudo o que a IA lembra dela?
Depende do serviço. Em sistemas que mantêm memórias separadamente do histórico, pode ser necessário excluir tanto a memória quanto a conversa original.
Uma memória pode estar errada?
Sim. Ela pode ter sido inferida incorretamente, estar desatualizada ou ter perdido relevância. Informações importantes devem ser confirmadas quando necessário.
Uma conversa nova começa sem nenhum contexto anterior?
Ela normalmente começa sem o histórico completo da conversa anterior, mas memórias, preferências ou outras formas de personalização podem ser novamente disponibilizadas ao sistema.
O que fica
Quando uma IA parece lembrar de você, não precisamos imaginar que existe uma mente digital guardando lembranças como uma pessoa faria.
O que existe é um sistema capaz de manter informações, selecionar algumas delas e colocá-las novamente em circulação quando parecem úteis.
Essa diferença muda bastante a forma de pensar sobre o assunto.
Contexto é o que está sobre a mesa agora.
Histórico é o arquivo.
Memória é aquilo que o sistema consegue trazer do arquivo de volta para a mesa.
Treinamento é alterar a própria máquina que trabalha sobre ela.
Entender essas quatro camadas ajuda a responder uma pergunta melhor do que simplesmente “a IA lembra de mim?”:
que informação este sistema está usando agora, de onde ela veio e eu ainda quero que ela seja usada?
Como este artigo foi produzido
Conteúdo produzido com apoio de inteligência artificial, a partir de documentação oficial dos principais serviços de IA e literatura científica sobre contexto e recuperação de informação. As afirmações factuais foram verificadas nas fontes consultadas e o texto passou por revisão humana antes da publicação.
Fontes consultadas
- OpenAI — Memory FAQ (consultada em 16/08/2026)
- OpenAI — Chat and File Retention Policies in ChatGPT (consultada em 16/08/2026)
- OpenAI — How your data is used to improve model performance (consultada em 16/08/2026)
- Anthropic — Use Claude's chat search and memory to build on previous context (consultada em 16/08/2026)
- Google — Get personalization with memory of your past Gemini chats (consultada em 16/08/2026)
- Google — Manage & delete your activity in Gemini Apps (consultada em 16/08/2026)
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (consultada em 16/08/2026)
- Liu et al. — Lost in the Middle: How Language Models Use Long Contexts (consultada em 16/08/2026)